
# কিছু কথা
বিশ্ববিদ্যালয় লাইফ এ বেশ কিছু পাপ করেছিলাম। তার মধ্যে একটা হল ডাটা স্ট্রাকচার এর কোর্স পাত্তা না দেয়া। আসল কথা কি, ডাটা স্ট্রাকচার কি, কেন লাগে এগুলো কিছুই বুঝতাম না। ফলে আগ্রহটাও থাকেনি। বিশ্ববিদ্যালয় ছেড়ে যখন প্রফেশনাল লাইফ এ ঢুকলাম, HTML, JS, PHP দিয়ে সুন্দর করে সাইট বানিয়ে দিচ্ছি। কিন্তু ডাটা স্ট্রাকচারটা কি? বুঝতেসিলাম না। এখন আসে পাসে ৩০দিনে ইন্টারনেট এ আয় করুন ডেভলপারদের অভাব নাই। কিন্তু যখন পিওর একজন ডেভেলপার/প্রোগ্রামার এর সাথে কথা বলি, লেখা পড়ি তারা প্রায় ডাটা স্ট্রাকচার আর এল্গোরিদম নিয়ে কথা বলেন। আমি গুগল করে ডেফিনেশন পড়তাম, পড়ে সেগুলো বুঝতামও। কিন্তু কেন যেন রিয়ালাইজেশন হচ্ছিল না। এই লেখাটার উদ্দেশ্য হল এই ডাটা স্ট্রাকচার কে ভাজি করে খেয়ে ফেলা। রিয়ালাইজেশন নিয়ে আসা। আমার গুরুর মতে বিশ্ববিদ্যালয় লাইফের পাপের প্রায়শ্চিত্ত করা। এই আর্টিকেলটা হবে ডাটা স্ট্রাকচার এর উপর একটা শর্ট নোট। আর্টিকেল লিখা হবে SCHAUM’S OUTLINE এর Data Structures By SEYMOUR LIPSCHUTZ এর বই কে ফলো করে।
# ডাটা স্ট্রাকচার
বিশ্ববিদ্যালয়ের লাইব্রেরিতে যাবার অভিজ্ঞতা আছে নিশ্চয়ই? সেখানে হাজার হাজার বই এর ভেতর নিজের ডিপার্টমেন্ট এর নির্দিষ্ট বইটা খুঁজে পেতে আমরা কি করি? ধরি আমি সিএসই এর স্টূডেন্ট। লাইব্রেরীতে গিয়ে লাইব্রেরিয়ানকে জিজ্ঞেস করব সিএসই ডিপ্ট এর বই কোন শেলফ এ। তিনি শেলফগুলোর নাম্বার বলে দিলেন। দেখা যাবে এই নাম্বারগুলো পর পর। তার মানে শেলফগুলো পর পর সাজানো আছে। এভাবে সব ডিপ্ট এর জন্যই শেলফ সাজানো। কেন? যাতে খোঁজা সহজ হয়। শেলফ নাম্বার পাবার পর সেখানে গিয়ে হয়ত এলফ্যাবেটিক অর্ডার এ বই খুঁজবো। এভাবে পুরো লাইব্রেরীটাকে সাজানো হয়েছে, একটা স্ট্রাকচার এ নিয়ে আসা হয়েছে। এখন এই বইগুলোকে আমরা ডাটা হিসেবে চিন্তা করলে পুরো লাইব্রেরীটা একটা ডাটা স্ট্রাকচার এ আছে।
একটা উদাহরণ, কম্পিউটার কিভাবে কাজ করে? আমাদের কম্পিউটার এর হার্ডডিস্ক থেকে সে ডাটা নেয়, সে ডাটার কিছু অংশ মেমরী/র্যাম এ রাখে দ্রুত একসেস করার জন্য(টেকনিকালি এটা আরো কমপ্লেক্স ব্যাপার, আমরা সেদিক না গিয়ে জাস্ট বুঝানোর জন্য এভাবে সংক্ষেপে বলছি) এরপর প্রসেসর সে ডাটা একসেস করে যখন প্রয়োজন হয়। ডাটার ধরণ অনুযায়ী বিভিন্ন স্ট্রাকচার করে তা র্যাম এ রাখা যায়। এটাই ডাটা স্ট্রাকচার। উপরের লাইব্রেরীর উদাহরণ আমাদের আরেকটা প্রশ্নের উত্তর দিয়ে দেয়, কেন ডাটা স্ট্রাকচার? কারন সহজে ডাটা খুঁজে পাওয়া যায়। লাইফটা সুন্দর হয়।
বইয়ের ভাষায়, ডাটা অনেক ভাবে সাজানো যায়। লজিকাল কিংবা ম্যাথমেটিকাল মডেল অনুসরণ করে ডাটা সাজানোই ডাটা স্ট্রাকচার। এই লজিকাল/ম্যাথমেটিকাল মডেলগুলো হল, Array, Linked List, Trees, Stack, Queue, Graph ইত্যাদি। নিচে আমরা এগুলোর একটা ধারণা নিতে চেষ্টা করব।
# Array
Array/Linear Array হল সবেচেয়ে সিম্পল ডাটা স্ট্রাকচার। Linear Array বলতে আমরা বুঝি একই ধরনের ডাটার একটা নির্দিষ্ট নাম্বার পর্যন্ত লিস্ট। Array দুটি উপদান নিয়ে গঠিত হয়। Element এবং Index. Element হল array তে ডাটাগুলো লিস্ট আকারে সংরক্ষন বা স্টোর করা হয়। আর Index হল array তে এই স্টোর করে রাখা ডাটার লোকেশন। এই Index নিউমেরিকাল নাম্বার হয়। নিচের উদাহরণটি দেখি।

Student নামের array তে ৬জন ছাত্রের লিস্ট পর পর আছে। এখানে index হিসেবে 1, 2 3… নিউমেরিকাল নাম্বার ব্যবহার করা হয়েছে এবং element হিসেবে ছাত্রদের নাম ব্যবহার করা হয়েছে। এখন আমরা যদি বলি Student[1] তাহলে এটা John Brown কে বুঝাবে। যদি বলি Student[5] তাহলে Mary Reed কে বুঝাবে। সুতরাং এভাবে ডাটা সাজানোই হল Array Model ফলো করে ডাটা স্ট্রাকচার প্রয়োগ করা।
# Linked List
আমরা একটা ডাটা স্ট্রাকচার ধরে নেই যেটা দুভাগে দু ধরনের ডাটা স্টোর করে। নিচের ছবির মত।
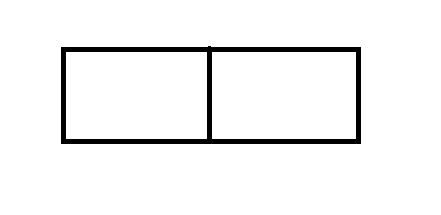
এই স্ট্রাকচার এর প্রথম অংশে থাকবে ডাটা। পরের অংশে কি থাকবে সেটা জানার আগে নিচে আরেকটা ছবি খেয়াল করি।
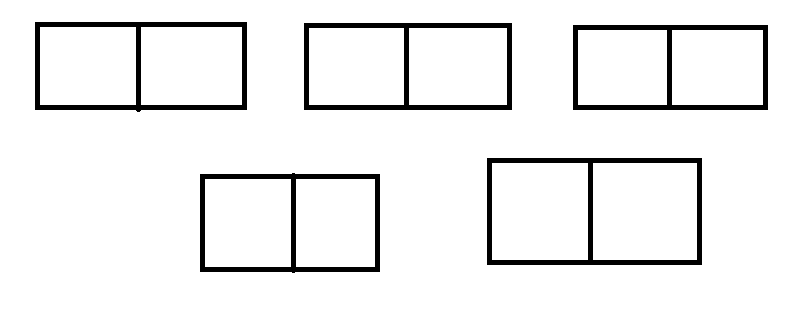
এখানে অনেকগুলো সিমিলার ডাটা স্ট্রাকচার আছে। প্রতিটির প্রথম অংশে আমরা ডাটা রাখতে পারবো। এবং ২য় অংশে থাকবে অন্য আরেকটি সিমিলার ডাটা স্ট্রাকচার এর লিঙ্ক অথবা মেমোরি এড্রেস।

Linked list হল কতগুলো ডাটা স্ট্রাকচার যারা একটা লিঙ্ক এর মাধ্যমে কানেকটেড থাকে।
# Array vs Linked List
Array কে বলা হয় static data structure এবং linked list হল dynamic data structure. Array তে ডাটাগুলো মেমরীতে পর পর থাকে। যেমন ধরি number[5] array টা ৪বাইটের ইন্টিজার array। সুতরাং যদি number[0] এর মেমোরি লোকেশন x হয়, number[1] এর মেমোরি লোকেশন হবে x+4, number[2] এর মেমোরি লোকেশন হবে x+8 এভাবে x+12, x+16... ইত্যাদি। রান টাইম এ array এর length পরিবর্তন করা যায় না। Linked List এ array এর মত সিরিয়ালি ডাটা স্টোর করা হয় না। মেমোরির যেই cell এ ডাটা রাখা হয় সেই cell এর লোকেশন পূর্বের cell এ দেয়া থাকে। ফলে ইচ্ছে মতই ডাটা add করা যায় রান টাইম এও। কখন আমরা array ব্যবহার না করে linked list ব্যবহার করব? যখন আমরা জানবো না আমাদের কি পরিমাণ ডাটা স্টোর করা লাগবে। যেহেতু array তে ফিক্সড length। যেমন, Employee Management System এ ফিক্সড array ইউজ করা যাবেনা কারণ প্রায় ই নতুন এমপ্লয়ি জয়েন করতে পারে। সুতরাং এখানে linked list ব্যবহার করতে হবে।
# Trees
অনেক সময় বিভিন্ন ধরনের ডাটার মধ্যে hierarchical রিলেশনশীপ থাকে। যে ধরনের ডাটা স্ট্রাকচার এধরনের রিলেশনশীপ প্রতিফলিত করে সেটাই হল Rooted Tree কিংবা Tree। নিজের উদাহরণ থেকে এ সম্পর্কে ধারণা আরো পরিষ্কার হবে।

ধরি Employee নামে আমাদের একটা ডাটাবেজ টেবিল আছে এবং তার কিছু attribute হল SSN(Social Security Number), Name, Address, Age, Salary, Dependents. এই attribute গুলোর মধ্যে Name এর সাব ক্যাটাগরি থাকতে পারে যেমন, first name, last name, middle name। Address এরও city, street, ZIP এরকম সাব ক্যাটাগরি থাকতে পারে। এধরনের hierarchical রিলেশনশীপ থাকা ডাটা স্ট্রাকচারই হল trees.
# Stack
Stack কে Last in first out(LIFO) system নামেও চিনে অনেকে। রিয়েল লাইফ উদাহরণ এরকম, মনে করি একটি বক্স এ আমরা প্লেট রাখবো। বক্স এ প্লেট রাখতে হলে আমাকে একটার উপর একটা রাখতে হবে। এবং সেখান থেকে প্লেট নিতে হলে সবার উপরে যেই প্লেটটা আছে সেটা নিতে হবে। তার মানে যেই প্লেটটি সবার শেষ এ প্রবেশ করলো সেটাই আমরা সবার আগেই তুলে নিলাম। এটিই Stack।

টেকনিকাল উদাহরণ চাইলে, আমরা ব্রাউজার এর পূর্ববর্তী পেজ এ যাবার Back বাটনের কথা চিন্তা করতে পারি। মনে করি আমরা শুরুতে ভিজিট করলাম ফেসবুক, stack এ ফেসবুক রাখলাম। সেখান থেকে গেলাম ইউটিব। Stack এ ফেসবুক এর উপর ইউটিউব রাখলাম। এরপর গেলাম অ্যামাজন এর সাইট এ। এখন stack এ সবার উপর আছে অ্যামাজন। এখন Back বাটন ক্লিক করে গেলাম stack এ অ্যামাজন এর পরে থাকা ইউটিউব পেজ এ এবং এর পরে ফেসবুক পেজ এ।
# Queue
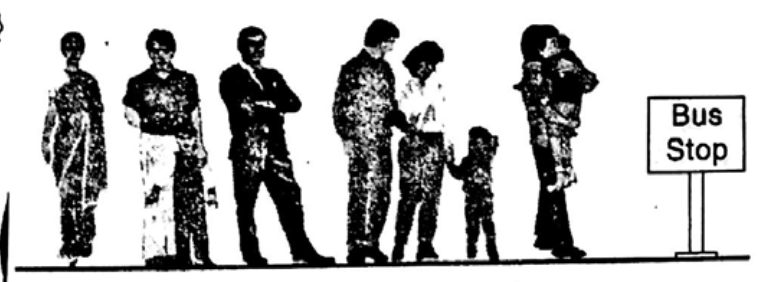
Queue কে First in first out(FIFO) নামেও বলা হয়ে থাকে। একটি বাসের লাইনের কথা চিন্তা করতে পারি আমরা। লাইনে সবার আগে যিনি থাকেন তিনিই সবার আগে বাস এ উঠতে পারেন। এভাবে একজনের পর একজন।
# Graph
ডাটা মাঝে মাঝে জোড়ায় জোড়ায় রিলেশনশীপ মেইন্টেইন করে। যেমন, এয়ারলাইনের রুট এর কথা চিন্তা করা যাক।

প্লেন শুধু মাত্র যায় এক শহর থেকে আরেক শহরে যেগুলো কানেক্টেড। Los Angeles কানেকটেড আছে Boston এবং Miami এর সাথে। ডাটা যখন এধরনের রিলেশনশীপ প্রতিফলিত করে তখন তাকে আমরা Graph ডাটা স্ট্রাকচার বলি।
# Element of Data Structure(Different Names)
ডাটা স্ট্রাকচার এর ডাটা কিংবা এলিমেন্ট কে অনেক নামে ডাকা হয়। নিচে একটা তালিকা দিলাম।
- Data elements
- Data items
- Item aggregate
- Record
- Node
- Data Object
# Data Structure Operation
ডাটা স্টাকচার এ frequently ব্যবহৃত operation গুলো নিয়ে আলোচনা করব এখানে।
- Traversing: নির্দিষ্ট একটা রেকর্ড কে খুঁজে প্রসেস করার জন্য প্রতিটা রেকর্ড কে একবার করে এক্সেস করাই হল traversing।
- Searching: কি ভ্যালু ব্যবহার করে কোন ডাটা স্ট্রাকচার থেকে ঐ ডাটার লোকেশন খুঁজে বের করা।
- Inserting: স্ট্রাকচার এ নতুন ডাটা এড করা।
- Deleting: কোন ডাটা স্ট্রাকচার থেকে মুছে ফেলা।
- Sorting:* রেকর্ড/ডাটা কে কোন লজিকাল অর্ডার এ সাজানো। যেমন, নাম সমূহ এলফ্যাবেটিকালি সাজানো।
- Merging: দুটো sorted ফাইল কে কম্বাইন করে একটি ফাইল এ পরিণত করা। মাঝে মাঝে দুই কিংবা ততধিক operation একসাথে হতে পারে। যেমন, স্ট্রাকচার এ একটা রেকর্ড/ডাটা search করলাম এরপর সেটিকে delete করলাম।
এই আর্টিকেলটা Data Structure এর একধরনের overview টাইপ আর্টিকেল। আমার ইচ্ছা আছে প্রতিটি টপিক নিয়ে ডিটেইলস লিখা কোডসহ। দেখা যাক।